Co naprawdę zawierają Państwa dane treningowe
Raport z pomiarów dowolnego zbioru danych tekstowych lub kodu: duplikaty, spójność językowa, dane osobowe, zgodność licencyjna, poprawność składni i pokrycie ze zbiorami ewaluacyjnymi. Stan przed kuracją i po niej, w jednym dokumencie.
Tekst i kod mają własne testy
Kodu nie ocenia się tak jak prozy. W kodzie liczy się uszkodzony plik źródłowy, ujawniony klucz lub nagłówek copyleft. W tekście liczy się błędna etykieta języka lub uszkodzony skan.
Zbiory danych tekstowych
- Inwentaryzacja: dokumenty, tokeny, rozkład długości, struktura języków i dziedzin
- Duplikaty dokładne i przybliżone
- Identyfikacja języka w porównaniu z podaną etykietą
- Metadane licencyjne w porównaniu z Państwa polityką licencyjną
- Jakość strukturalna: powtórzenia, błędy kodowania, fragmenty
- Wykryte dane osobowe: e-mail, telefon, IBAN, karta płatnicza, adres IP
- Pokrycie ze zbiorami ewaluacyjnymi
Zbiory danych z kodem
- Inwentaryzacja według języka programowania: pliki, tokeny, linie
- Pliki zduplikowane dokładnie i w przybliżeniu
- Poprawność składni: odsetek plików, które parsują się bez błędów
- Nagłówki licencyjne, w tym udział copyleft
- Ujawnione dane uwierzytelniające: klucze, tokeny, hasła zapisane na stałe w kodzie
- Pliki wygenerowane, zminifikowane i dołączone z zewnętrznych zależności (vendored)
- Pokrycie ze zbiorami ewaluacyjnymi dla kodu
Jedna liczba, z pokazanym sposobem obliczenia
Każdy test przelicza zmierzony odsetek defektów na wynik od 0 do 100 względem podanej tolerancji. Wskaźnik jest średnią ważoną, podawaną w przedziałach od A do E, dla danych przed kuracją i po niej.
Tolerancje i wagi są podane w każdym raporcie. Wskaźnik podsumowuje pomiary. Nie stanowi gwarancji tego, jak będzie działał model wytrenowany na tych danych.
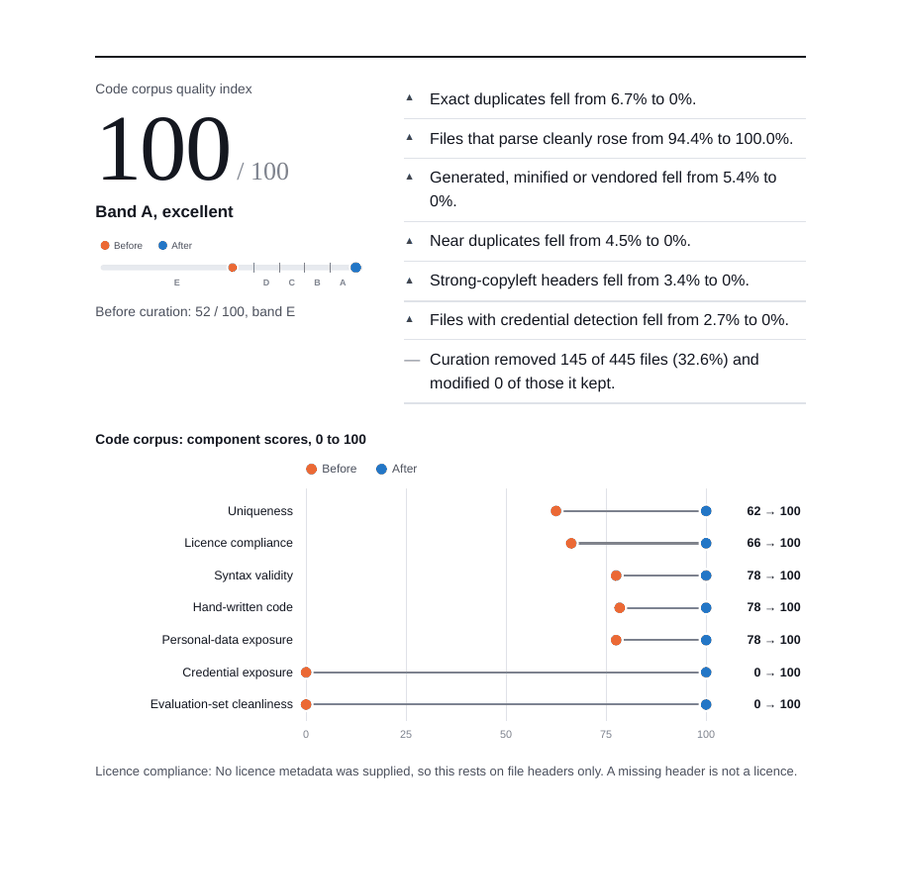
Strona z raportu dotyczącego syntetycznych danych testowych z celowo wprowadzonymi defektami. Liczby nie pochodzą ze zbioru danych klienta.
Pięć zasad, których trzyma się raport
Tylko liczby
Raport zawiera liczebności, odsetki i rozkłady. Nie zawiera żadnego tekstu z Państwa danych, a małe grupy są łączone, aby żadna liczba nie wskazywała na garstkę dokumentów.
Przetwarzanie lokalne
Pomiar odbywa się na naszej maszynie lub w Państwa środowisku. Żadna treść zbioru danych nie jest wysyłana do usługi zewnętrznej.
Powtarzalność
Zapisujemy wersję narzędzia, ustawienia, tokenizer i cyfrowy odcisk danych. Te same dane wejściowe dają te same wyniki.
Wykryte, a nie nieobecne
Skany raportują to, co zostało wykryte. Zero nie jest przedstawiane jako dowód, że niczego nie ma, a każda sekcja podaje swoje znane ograniczenia.
Państwa prywatne zbiory ewaluacyjne
Państwa własny benchmark można sprawdzić pod kątem przecieku. Jest on przekształcany w indeks oparty na hashach, którego nie da się zamienić z powrotem na tekst.
Cztery momenty, w których warto mierzyć
Przed zakupem danych
Porównanie próbki dostawcy z tym, co deklaruje oferta.
Przed treningiem
Wykrycie duplikatów, danych osobowych i przecieku benchmarków, póki ich usunięcie jest jeszcze tanie.
Po kuracji
Pokazanie w liczbach, co zmieniło czyszczenie, dla własnego zespołu lub dla audytora.
Przy sprzedaży danych
Niezależny raport jakości dla kupujących, przekazywany razem z kartą zbioru danych.
Co Państwo otrzymują
Przesłanie lub hosting
Przesyłają Państwo zbiór danych po podpisaniu NDA albo mierzymy go w Państwa środowisku.
Wykonujemy pomiar
Pomiar przeprowadza CurateLM. Samo narzędzie nie jest przekazywane.
Otrzymują Państwo raport
Raport w formacie PDF, wersja HTML oraz plik JSON ze wszystkimi liczbami.
Pytania o benchmark
Czy raport zawiera jakiekolwiek nasze dane?
Nie. Zawiera wyłącznie liczby zagregowane. Wykryte adresy e-mail, klucze i podobne wartości są zliczane i nigdy nie są zapisywane.
Czy mogą Państwo sprawdzić nasze dane względem naszego prywatnego benchmarku?
Tak. Państwa zbiór ewaluacyjny jest przekształcany w indeks oparty na hashach na maszynie, która wykonuje pomiar. Indeks nie zawiera tekstu benchmarku.
Czy dobry wskaźnik gwarantuje jakość modelu?
Nie. Raport podaje, co zostało zmierzone i w jaki sposób. Nie jest poradą prawną, opinią licencyjną ani prognozą wydajności modelu.
Dla jakich języków programowania można sprawdzić składnię?
Dla ponad dwudziestu, w tym Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL i Fortran. Języki bez parsera są raportowane jako niesprawdzone, a nie jako błędne.
Czy możemy zamówić benchmark bez zakupu danych lub kuracji?
Tak. Benchmark jest odrębną usługą. Jest też częścią projektów kuracji danych jako raport przed kuracją i po niej.
Zleć pomiar zbioru danych
Proszę napisać, czy to tekst, kod, czy jedno i drugie, oraz jaki jest przybliżony rozmiar zbioru.
Zamów benchmark