Sepa qué hay en sus datos de entrenamiento
Un informe con mediciones sobre cualquier conjunto de datos de texto o código: duplicados, integridad lingüística, datos personales, cumplimiento de licencias, validez sintáctica y solapamiento con conjuntos de evaluación. Antes y después de la curación, en un solo documento.
El texto y el código tienen sus propias comprobaciones
El código no se evalúa como la prosa. En el código importa un archivo fuente defectuoso, una clave filtrada o una cabecera copyleft. En el texto importa una etiqueta de idioma errónea o un escaneo dañado.
Conjuntos de datos de texto
- Inventario: documentos, tokens, distribución de longitudes, distribución de idiomas y dominios
- Duplicados exactos y casi duplicados
- Identificación del idioma frente a la etiqueta suministrada
- Metadatos de licencia frente a su política de licencias
- Calidad estructural: repeticiones, errores de codificación, fragmentos
- Datos personales detectados: correo electrónico, teléfono, IBAN, tarjeta de pago, dirección IP
- Solapamiento con conjuntos de evaluación
Conjuntos de datos de código
- Inventario por lenguaje de programación: archivos, tokens, líneas
- Archivos duplicados exactos y casi duplicados
- Validez sintáctica: proporción de archivos que se analizan sin errores
- Cabeceras de licencia, incluida la proporción de copyleft
- Credenciales filtradas: claves, tokens, contraseñas escritas en el código
- Archivos generados, minificados y de terceros incluidos en el repositorio
- Solapamiento con conjuntos de evaluación de código
Una sola cifra, con el cálculo a la vista
Cada comprobación convierte una tasa de defectos medida en una puntuación de 0 a 100 respecto a una tolerancia declarada. El índice es la media ponderada y se presenta en bandas de la A a la E, para los datos antes y después de la curación.
Las tolerancias y los pesos figuran en todos los informes. El índice resume las mediciones. No garantiza el rendimiento de un modelo entrenado con esos datos.
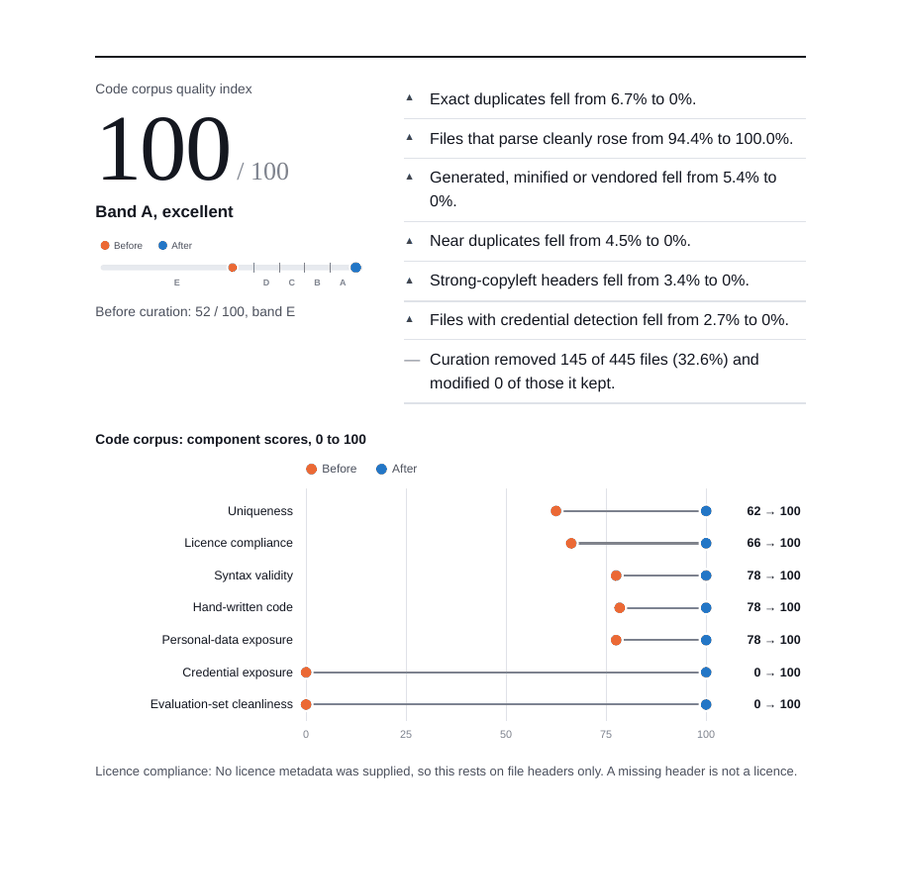
Página de un informe sobre datos de prueba sintéticos con defectos introducidos a propósito. Las cifras no proceden del conjunto de datos de ningún cliente.
Cinco reglas que el informe cumple
Solo cifras
El informe recoge recuentos, tasas y distribuciones. No contiene texto de sus datos, y los grupos pequeños se agrupan para que ninguna cifra apunte a unos pocos documentos.
Procesamiento local
La medición se ejecuta en nuestra máquina o dentro de su entorno. No se envía contenido del conjunto de datos a ningún servicio externo.
Reproducible
Se registran la versión de la herramienta, la configuración, el tokenizador y una huella de los datos. La misma entrada da las mismas cifras.
Detectado, no ausente
Los análisis informan de lo que se ha detectado. Un cero no se presenta como prueba de que no haya nada, y cada sección indica sus límites conocidos.
Sus conjuntos de evaluación privados
Se puede comprobar si su propio benchmark se ha filtrado. Se convierte en un índice de hashes que no puede volver a transformarse en texto.
Cuatro momentos para medir
Antes de comprar datos
Compare la muestra de un proveedor con lo que afirma la oferta.
Antes de entrenar
Encuentre duplicados, datos personales y filtraciones de benchmarks cuando corregirlos aún es barato.
Después de la curación
Demuestre con cifras qué ha cambiado la limpieza, ante su propio equipo o ante un auditor.
Cuando vende datos
Envíe a los compradores un informe de calidad independiente junto con la ficha del conjunto de datos.
Qué recibe
Enviar o alojar
Usted envía el conjunto de datos bajo NDA, o lo medimos dentro de su entorno.
Nosotros medimos
CurateLM ejecuta la medición. La herramienta en sí no se entrega.
Usted recibe el informe
Un informe en PDF, una versión en HTML y un archivo JSON con todas las cifras.
Preguntas sobre el benchmark
¿Contiene el informe alguno de nuestros datos?
No. Solo contiene cifras agregadas. Las direcciones de correo electrónico, las claves y otros valores similares que se detectan se cuentan y nunca se almacenan.
¿Pueden comprobar nuestros datos frente a nuestro propio benchmark privado?
Sí. Su conjunto de evaluación se convierte en un índice de hashes en la máquina que ejecuta la medición. El índice no contiene texto del benchmark.
¿Un buen índice garantiza la calidad del modelo?
No. El informe indica qué se ha medido y cómo. No es asesoramiento jurídico, ni un dictamen sobre licencias, ni una predicción del rendimiento del modelo.
¿En qué lenguajes de programación se puede comprobar la sintaxis?
En más de veinte, entre ellos Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL y Fortran. Los lenguajes sin analizador sintáctico se indican como no comprobados, no como fallidos.
¿Podemos contratar el benchmark sin comprar datos ni curación?
Sí. El benchmark es un servicio independiente. También se incluye en los proyectos de curación de datos como informe del antes y el después.
Haga medir un conjunto de datos
Díganos si es texto, código o ambos, y qué tamaño aproximado tiene.
Solicitar un benchmark