Weet wat er in uw trainingsdata zit
Een rapport met meetresultaten over elke tekst- of codedataset: duplicaten, taalintegriteit, persoonsgegevens, licentieconformiteit, syntactische geldigheid en overlap met evaluatiesets. Voor en na curatie, in één document.
Tekst en code krijgen elk hun eigen controles
Code wordt niet beoordeeld zoals proza. Bij code telt een defect bronbestand, een gelekte sleutel of een copyleftheader. Bij tekst telt een verkeerd taallabel of een beschadigde scan.
Tekstdatasets
- Inventaris: documenten, tokens, lengteverdeling, verdeling van talen en domeinen
- Exacte duplicaten en bijna-duplicaten
- Taalidentificatie, vergeleken met het meegeleverde label
- Licentiemetadata, getoetst aan uw licentiebeleid
- Structurele kwaliteit: herhaling, coderingsfouten, fragmenten
- Gedetecteerde persoonsgegevens: e-mail, telefoon, IBAN, betaalkaart, IP-adres
- Overlap met evaluatiesets
Codedatasets
- Inventaris per programmeertaal: bestanden, tokens, regels
- Exact en bijna identieke bestanden
- Syntactische geldigheid: aandeel bestanden dat zonder fouten wordt geparset
- Licentieheaders, inclusief het aandeel copyleft
- Gelekte inloggegevens: sleutels, tokens, hardgecodeerde wachtwoorden
- Gegenereerde, geminificeerde en overgenomen (vendored) bestanden
- Overlap met evaluatiesets voor code
Eén cijfer, met de berekening erbij
Elke controle zet een gemeten foutpercentage om in een score van 0 tot 100, afgezet tegen een vermelde tolerantie. De index is het gewogen gemiddelde, weergegeven in klassen van A tot E, voor de data voor en na curatie.
Toleranties en wegingen staan in elk rapport. De index vat de metingen samen. Het is geen garantie voor de prestaties van een model dat op de data is getraind.
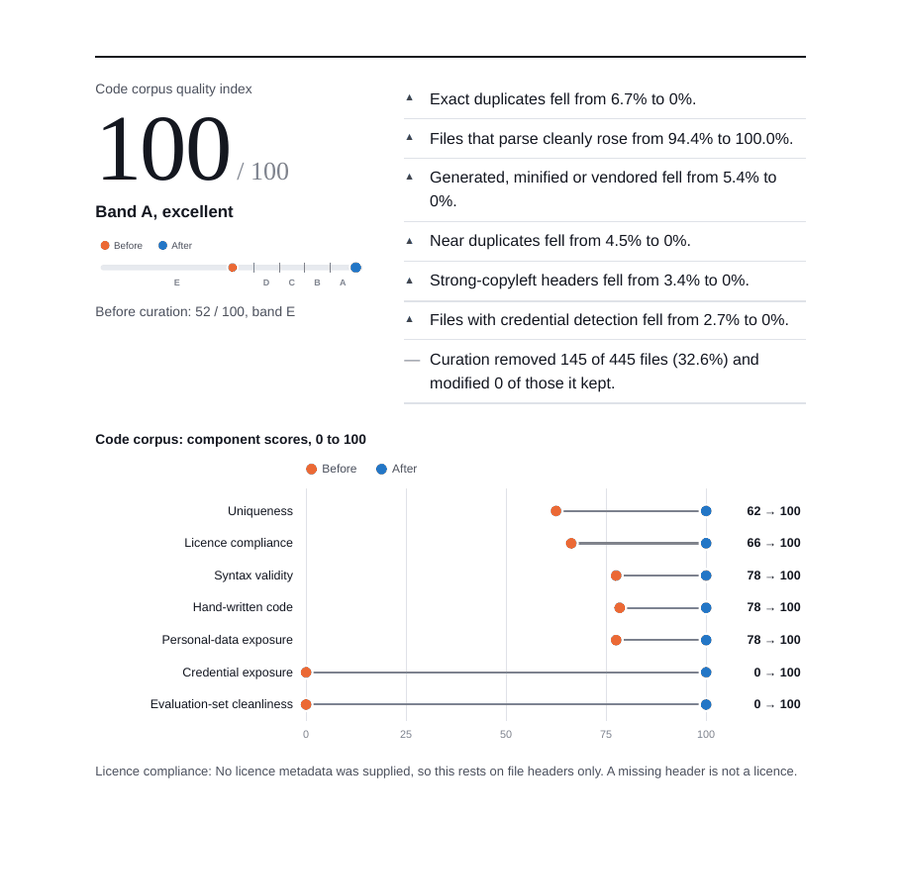
Een pagina uit een rapport over synthetische testdata met bewust aangebrachte fouten. De cijfers komen niet uit een dataset van een klant.
Vijf regels waaraan het rapport zich houdt
Alleen cijfers
Het rapport bevat aantallen, percentages en verdelingen. Het bevat geen tekst uit uw data. Kleine groepen worden samengevoegd, zodat geen enkel cijfer naar een handvol documenten verwijst.
Lokale verwerking
De meting draait op onze machine of binnen uw omgeving. Er wordt geen inhoud van de dataset naar een externe dienst gestuurd.
Reproduceerbaar
Toolversie, instellingen, tokenizer en een vingerafdruk van de data worden vastgelegd. Dezelfde invoer geeft dezelfde cijfers.
Gedetecteerd, niet afwezig
Scans rapporteren wat er is gedetecteerd. Een nul wordt niet gepresenteerd als bewijs dat er niets is, en elke sectie vermeldt de bekende beperkingen.
Uw besloten evaluatiesets
Uw eigen benchmark kan op lekkage worden gecontroleerd. Deze wordt omgezet in een gehashte index die niet meer naar tekst kan worden teruggebracht.
Vier momenten om te meten
Voordat u data koopt
Toets de sample van een leverancier aan wat de aanbieding belooft.
Voordat u traint
Vind duplicaten, persoonsgegevens en benchmarklekkage zolang herstel nog goedkoop is.
Na curatie
Laat in cijfers zien wat het opschonen heeft veranderd, voor uw eigen team of voor een auditor.
Wanneer u data verkoopt
Stuur afnemers een onafhankelijk kwaliteitsrapport naast uw dataset card.
Wat u ontvangt
Versturen of hosten
U stuurt de dataset onder NDA, of wij meten deze binnen uw omgeving.
Wij meten
CurateLM voert de meting uit. De tool zelf wordt niet overgedragen.
U krijgt het rapport
Een pdf-rapport, een HTML-versie en een JSON-bestand met alle cijfers.
Vragen over de benchmark
Bevat het rapport iets van onze data?
Nee. Het bevat alleen geaggregeerde cijfers. Gedetecteerde e-mailadressen, sleutels en vergelijkbare waarden worden geteld en nooit opgeslagen.
Kunt u onze data toetsen aan onze eigen besloten benchmark?
Ja. Uw evaluatieset wordt omgezet in een gehashte index op de machine waarop de meting draait. De index bevat geen tekst uit de benchmark.
Is een goede index een garantie voor modelkwaliteit?
Nee. Het rapport vermeldt wat er is gemeten en hoe. Het is geen juridisch advies, geen licentieoordeel en geen voorspelling van modelprestaties.
Voor welke programmeertalen kan de syntaxis worden gecontroleerd?
Meer dan twintig, waaronder Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL en Fortran. Talen zonder parser worden gerapporteerd als niet gecontroleerd, niet als afgekeurd.
Kunnen wij de benchmark afnemen zonder data of curatie te kopen?
Ja. De benchmark is een aparte dienst. Bij datacuratieprojecten is hij ook inbegrepen als het rapport van voor en na.
Laat een dataset meten
Vertel ons of het om tekst, code of beide gaat, en hoe groot de dataset ongeveer is.
Vraag een benchmark aan