Sapere cosa c'è nei vostri dati di addestramento
Un report basato su misurazioni per qualsiasi dataset di testo o di codice: duplicati, integrità linguistica, dati personali, conformità delle licenze, validità sintattica e sovrapposizione con i set di valutazione. Prima e dopo la curation, in un unico documento.
Testo e codice hanno controlli propri
Il codice non si valuta come la prosa. Nel codice contano un file sorgente che non funziona, una chiave esposta o un'intestazione copyleft. Nel testo contano un'etichetta di lingua sbagliata o una scansione danneggiata.
Dataset di testo
- Inventario: documenti, token, distribuzione delle lunghezze, ripartizione per lingua e dominio
- Duplicati esatti e quasi duplicati
- Identificazione della lingua rispetto all'etichetta fornita
- Metadati di licenza rispetto alla vostra policy sulle licenze
- Qualità strutturale: ripetizioni, errori di codifica, frammenti
- Dati personali rilevati: e-mail, telefono, IBAN, carta di pagamento, indirizzo IP
- Sovrapposizione con i set di valutazione
Dataset di codice
- Inventario per linguaggio di programmazione: file, token, righe
- File duplicati esatti e quasi duplicati
- Validità sintattica: quota di file che superano il parsing senza errori
- Intestazioni di licenza, compresa la quota copyleft
- Credenziali esposte: chiavi, token, password scritte nel codice
- File generati, minificati e di terze parti inclusi nel repository
- Sovrapposizione con i set di valutazione per il codice
Un solo valore, con il calcolo in chiaro
Ogni controllo converte un tasso di difetti misurato in un punteggio da 0 a 100 rispetto a una tolleranza dichiarata. L'indice è la media ponderata, espressa in fasce da A a E, per i dati prima e dopo la curation.
Tolleranze e pesi sono riportati in ogni report. L'indice riassume le misurazioni. Non è una garanzia delle prestazioni di un modello addestrato su quei dati.
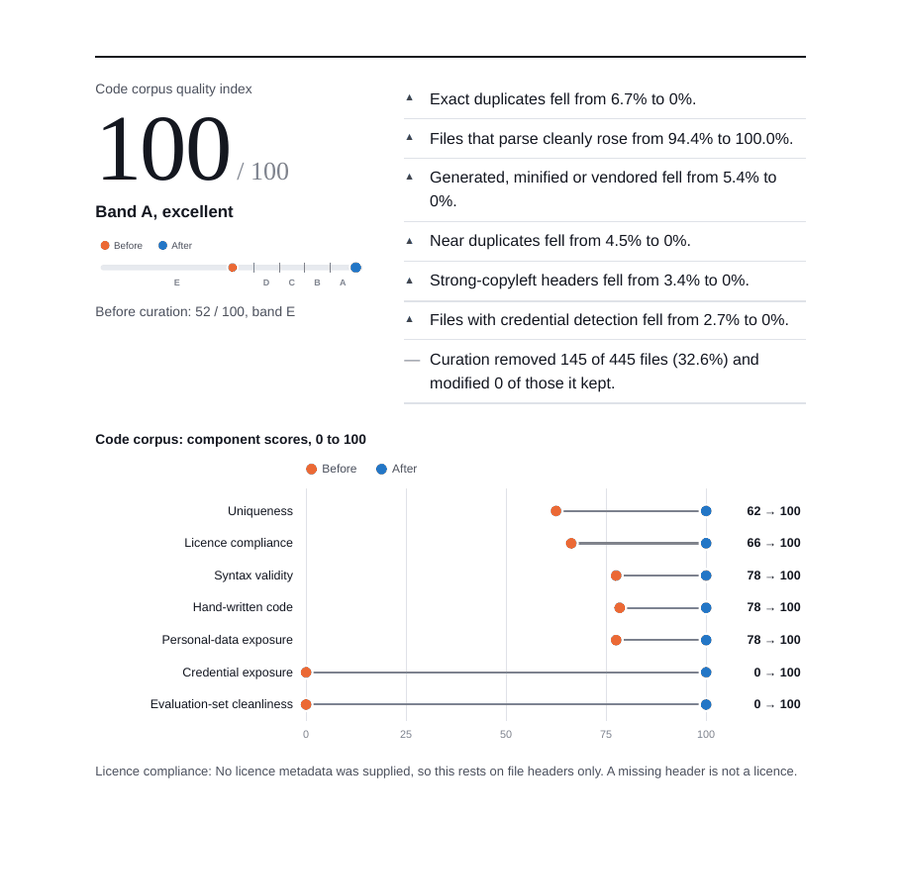
Una pagina di un report su dati di test sintetici con difetti inseriti di proposito. Le cifre non provengono dal dataset di un cliente.
Cinque regole che il report rispetta
Solo numeri
Il report contiene conteggi, tassi e distribuzioni. Non contiene testo dei vostri dati, e i gruppi piccoli vengono accorpati perché nessuna cifra rimandi a una manciata di documenti.
Elaborazione in locale
La misurazione viene eseguita sulla nostra macchina o nel vostro ambiente. Nessun contenuto del dataset viene inviato a un servizio esterno.
Riproducibile
Vengono registrati versione dello strumento, impostazioni, tokenizer e un'impronta dei dati. Lo stesso input produce le stesse cifre.
Rilevato, non assente
Le scansioni riportano ciò che è stato rilevato. Uno zero non viene presentato come prova che non ci sia nulla, e ogni sezione indica i propri limiti noti.
I vostri set di valutazione privati
Il vostro benchmark può essere controllato per verificare eventuali fughe nei dati. Viene convertito in un indice di hash che non può essere riconvertito in testo.
Quattro momenti in cui misurare
Prima di acquistare dati
Verificate il campione di un fornitore rispetto a quanto dichiarato nell'offerta.
Prima dell'addestramento
Individuate duplicati, dati personali e fughe di benchmark finché correggerli costa ancora poco.
Dopo la curation
Mostrate in cifre cosa ha cambiato la pulizia, al vostro team o a un revisore.
Quando vendete dati
Inviate agli acquirenti un report di qualità indipendente insieme alla scheda del dataset.
Cosa ricevete
Invio o ambiente vostro
Inviate il dataset sotto NDA, oppure lo misuriamo nel vostro ambiente.
Noi misuriamo
CurateLM esegue la misurazione. Lo strumento in sé non viene consegnato.
Ricevete il report
Un report in PDF, una versione HTML e un file JSON con tutte le cifre.
Domande sul benchmark
Il report contiene parti dei nostri dati?
No. Contiene solo numeri aggregati. Gli indirizzi e-mail, le chiavi e i valori simili rilevati vengono contati e mai memorizzati.
Potete confrontare i nostri dati con il nostro benchmark privato?
Sì. Il vostro set di valutazione viene convertito in un indice di hash sulla macchina che esegue la misurazione. L'indice non contiene alcun testo del benchmark.
Un buon indice è una garanzia della qualità del modello?
No. Il report indica cosa è stato misurato e come. Non è una consulenza legale, non è un parere sulle licenze e non è una previsione delle prestazioni del modello.
Per quali linguaggi di programmazione è possibile il controllo sintattico?
Più di venti, tra cui Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL e Fortran. I linguaggi privi di parser vengono riportati come non controllati, non come non superati.
Possiamo avere il benchmark senza acquistare dati o curation?
Sì. Il benchmark è un servizio a sé. È inoltre incluso nei progetti di data curation come report prima e dopo.
Fate misurare un dataset
Diteci se si tratta di testo, codice o entrambi, e quanto è grande all'incirca.
Richiedi un benchmark