Wissen, was in Ihren Trainingsdaten steckt
Ein gemessener Bericht zu jedem Text- oder Code-Datensatz: Duplikate, Sprachintegrität, personenbezogene Daten, Lizenzkonformität, Syntaxprüfung und Überschneidung mit Evaluationsdatensätzen. Vor und nach der Aufbereitung in einem Dokument.
Text und Code erhalten eigene Prüfungen
Code wird nicht wie Fließtext beurteilt. Bei Code zählen eine defekte Quelldatei, ein offener Schlüssel oder ein Copyleft-Hinweis. Bei Text zählen ein falsches Sprachlabel oder ein beschädigter Scan.
Text-Datensätze
- Bestand: Dokumente, Tokens, Längenverteilung, Sprach- und Themenmix
- Exakte und nahezu identische Duplikate
- Spracherkennung im Abgleich mit dem gelieferten Label
- Lizenz-Metadaten im Abgleich mit Ihrer Lizenzrichtlinie
- Strukturelle Qualität: Wiederholungen, Kodierungsfehler, Fragmente
- Erkannte personenbezogene Daten: E-Mail, Telefon, IBAN, Zahlungskarte, IP-Adresse
- Überschneidung mit Evaluationsdatensätzen
Code-Datensätze
- Bestand je Programmiersprache: Dateien, Tokens, Zeilen
- Exakte und nahezu identische Dateien
- Syntaxprüfung: Anteil der Dateien, die fehlerfrei parsen
- Lizenz-Header, einschließlich Copyleft-Anteil
- Offengelegte Zugangsdaten: Schlüssel, Tokens, fest eingetragene Passwörter
- Generierte, minifizierte und übernommene Dateien
- Überschneidung mit Code-Evaluationsdatensätzen
Eine Kennzahl, mit offenem Rechenweg
Jede Prüfung rechnet eine gemessene Fehlerquote gegen eine ausgewiesene Toleranz in einen Wert von 0 bis 100 um. Der Index ist das gewichtete Mittel, ausgewiesen in den Stufen A bis E, für die Daten vor und nach der Aufbereitung.
Toleranzen und Gewichte stehen in jedem Bericht. Der Index fasst die Messungen zusammen. Er ist keine Garantie dafür, wie ein mit den Daten trainiertes Modell abschneidet.
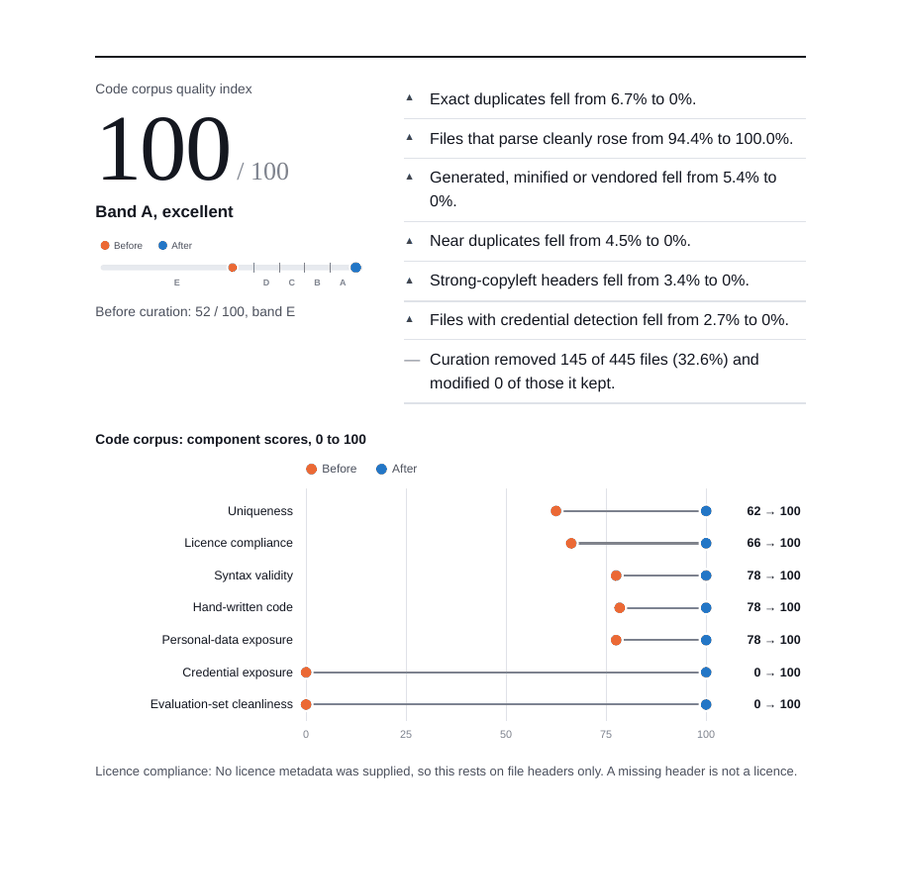
Eine Seite aus einem Bericht über synthetische Testdaten mit eingebauten Fehlern. Die Zahlen stammen nicht aus einem Kundendatensatz.
Fünf Regeln, die der Bericht einhält
Nur Zahlen
Der Bericht enthält Zählungen, Quoten und Verteilungen. Er enthält keinen Text aus Ihren Daten, und kleine Gruppen werden zusammengefasst, damit keine Zahl auf wenige Dokumente zeigt.
Lokale Verarbeitung
Die Messung läuft auf unserem Rechner oder in Ihrer Umgebung. Es werden keine Inhalte an einen externen Dienst gesendet.
Reproduzierbar
Werkzeugversion, Einstellungen, Tokenizer und ein Fingerabdruck der Daten werden festgehalten. Dieselbe Eingabe ergibt dieselben Zahlen.
Erkannt, nicht ausgeschlossen
Prüfungen berichten, was erkannt wurde. Eine Null gilt nicht als Beweis, dass nichts vorhanden ist, und jeder Abschnitt nennt seine bekannten Grenzen.
Ihre eigenen Evaluationsdatensätze
Ihr eigener Benchmark kann auf Überschneidung geprüft werden. Er wird in einen Hash-Index umgewandelt, aus dem sich kein Text zurückgewinnen lässt.
Vier Anlässe für eine Messung
Vor dem Datenkauf
Prüfen Sie die Stichprobe eines Anbieters gegen die Angaben im Angebot.
Vor dem Training
Finden Sie Duplikate, personenbezogene Daten und Benchmark-Überschneidungen, solange die Korrektur noch günstig ist.
Nach der Aufbereitung
Zeigen Sie in Zahlen, was die Bereinigung verändert hat, für Ihr Team oder für eine Prüfung.
Beim Datenverkauf
Geben Sie Käufern neben der Dataset Card einen unabhängigen Qualitätsbericht mit.
Was Sie erhalten
Senden oder bereitstellen
Sie senden den Datensatz unter NDA, oder wir messen ihn in Ihrer Umgebung.
Wir messen
CurateLM führt die Messung durch. Das Werkzeug selbst wird nicht übergeben.
Sie erhalten den Bericht
Ein PDF-Bericht, eine HTML-Fassung und eine JSON-Datei mit allen Kennzahlen.
Fragen zum Benchmark
Enthält der Bericht Inhalte aus unseren Daten?
Nein. Er enthält ausschließlich aggregierte Zahlen. Erkannte E-Mail-Adressen, Schlüssel und ähnliche Werte werden gezählt und nie gespeichert.
Können Sie unsere Daten gegen unseren eigenen Benchmark prüfen?
Ja. Ihr Evaluationsdatensatz wird auf dem Rechner, der die Messung ausführt, in einen Hash-Index umgewandelt. Der Index enthält keinen Benchmark-Text.
Ist ein guter Index eine Garantie für Modellqualität?
Nein. Der Bericht hält fest, was gemessen wurde und wie. Er ist keine Rechtsberatung, kein Lizenzgutachten und keine Vorhersage der Modellleistung.
Für welche Programmiersprachen ist eine Syntaxprüfung möglich?
Mehr als zwanzig, darunter Python, C, C++, Java, JavaScript, TypeScript, Rust, Go, SQL, COBOL und Fortran. Sprachen ohne Parser werden als nicht geprüft ausgewiesen, nicht als fehlerhaft.
Gibt es den Benchmark auch ohne Datenkauf oder Aufbereitung?
Ja. Der Benchmark ist ein eigener Service. Bei Projekten zur Datenaufbereitung ist er als Vorher-Nachher-Bericht enthalten.
Lassen Sie einen Datensatz vermessen
Sagen Sie uns, ob es um Text, Code oder beides geht und wie groß der Datensatz ungefähr ist.
Benchmark anfragen